
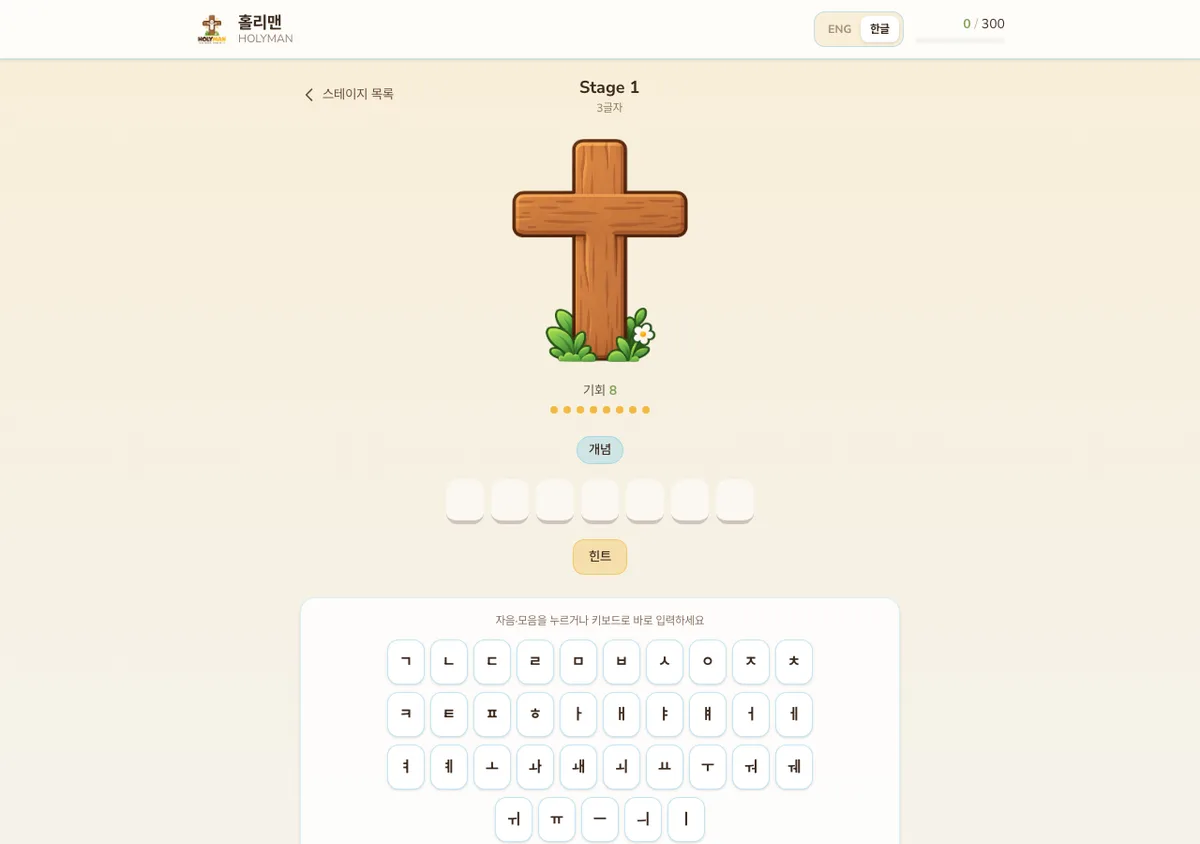
홀리맨은 성경 단어를 맞히는 행맨 게임이다. 영어 모드는 익숙한 규칙 그대로 알파벳을 하나씩 고른다. 문제는 한국어 모드였다. 영어 단어는 글자 하나가 곧 칸 하나지만, 한글은 "예수"처럼 두 글자 안에 자음과 모음이 네 개 들어 있다. 음절 단위로 맞히게 하면 고를 수 있는 글자가 수천 개가 되어 게임이 되지 않는다. 그래서 홀리맨은 한글 단어를 자음과 모음으로 분해해서 칸을 만든다. "예수"는 ㅇ, ㅖ, ㅅ, ㅜ 네 칸이 된다.
이 글은 그 분해를 어떻게 구현했는지, 그리고 한글 입력기(IME)와 게임을 연결하며 만난 문제를 정리한다.
한글 음절은 계산으로 분해할 수 있다
유니코드의 한글 음절 영역(U+AC00 "가" ~ U+D7A3 "힣")은 규칙적으로 배열되어 있다. 초성 19개, 중성 21개, 종성 28개(받침 없음 포함)를 조합한 11,172자가 정해진 순서로 들어 있다. 그래서 음절의 코드값만 알면 초성·중성·종성을 나눗셈으로 구할 수 있다.
음절 코드 = 0xAC00 + (초성 번호 × 21 + 중성 번호) × 28 + 종성 번호
이를 거꾸로 풀면 다음과 같다. 21 × 28 = 588이므로 588로 나눈 몫이 초성, 나머지를 28로 나눈 몫이 중성, 28로 나눈 나머지가 종성이다.
const INITIALS = ["ㄱ","ㄱㄱ","ㄴ","ㄷ","ㄷㄷ","ㄹ","ㅁ","ㅂ","ㅂㅂ","ㅅ","ㅅㅅ","ㅇ","ㅈ","ㅈㅈ","ㅊ","ㅋ","ㅌ","ㅍ","ㅎ"];
const VOWELS = ["ㅏ","ㅐ","ㅑ","ㅒ","ㅓ","ㅔ","ㅕ","ㅖ","ㅗ","ㅘ","ㅙ","ㅚ","ㅛ","ㅜ","ㅝ","ㅞ","ㅟ","ㅠ","ㅡ","ㅢ","ㅣ"];
const FINALS = ["","ㄱ","ㄱㄱ","ㄱㅅ","ㄴ","ㄴㅈ","ㄴㅎ","ㄷ","ㄹ","ㄹㄱ","ㄹㅁ","ㄹㅂ","ㄹㅅ","ㄹㅌ","ㄹㅍ","ㄹㅎ",
                "ㅁ","ㅂ","ㅂㅅ","ㅅ","ㅅㅅ","ㅇ","ㅈ","ㅊ","ㅋ","ㅌ","ㅍ","ㅎ"];

export function decomposeHangul(value: string): string {
  return Array.from(value).map((char) => {
    const code = char.charCodeAt(0);
    if (code < 0xac00 || code > 0xd7a3) return char.toUpperCase(); // 한글 음절이 아니면 그대로
    const index = code - 0xac00;
    return INITIALS[Math.floor(index / 588)]
         + VOWELS[Math.floor((index % 588) / 28)]
         + FINALS[index % 28];
  }).join("");
}
decomposeHangul("예수")는 "ㅇㅖㅅㅜ"를 돌려준다. 한글이 아닌 문자는 대문자로 바꿔 그대로 둔다. 영어 단어도 같은 함수를 통과시키면 대문자 알파벳 배열이 되므로, 게임 로직은 언어와 상관없이 "문자열의 각 글자를 맞힌다"는 하나의 규칙으로 동작한다.
실제 함수로 몇 가지 입력을 돌려 본 결과는 다음과 같다(Node v22.22.2, macOS 26.6.2 arm64, 2026-10-23, 홀리맨 src/utils/hangul.ts).
| 입력 | decomposeHangul 결과 |
|---|---|
| 과 | ㄱㅘ |
| 꽃 | ㄱㄱㅗㅊ |
| 닭 | ㄷㅏㄹㄱ |
| 읊 | ㅇㅡㄹㅍ |
| 은혜 | ㅇㅡㄴㅎㅖ |
| ㄲ (낱자) | ㄱㄱ |
| ㅘ (낱자) | ㅘ |
| 십자가 | ㅅㅣㅂㅈㅏㄱㅏ |
쌍자음(꽃의 ㄲ)과 겹받침(닭의 ㄺ, 읊의 ㄿ)은 쪼개지고, 겹모음(ㅘ, ㅖ)은 쪼개지지 않고 그대로 남는다.
쌍자음은 쪼개고, 겹모음은 그대로 둔다
위 표를 자세히 보면 일관되지 않은 부분이 있다. 쌍자음 ㄲ, ㄸ, ㅃ, ㅆ, ㅉ은 표에 "ㄱㄱ", "ㄷㄷ"처럼 두 글자로 들어 있고, 겹받침 ㄳ, ㄺ, ㅄ 등도 "ㄱㅅ", "ㄹㄱ", "ㅂㅅ"으로 쪼개져 있다. 반면 겹모음 ㅘ, ㅝ, ㅢ 등은 하나의 글자로 남아 있다.
이 차이는 화면 키보드에 무엇을 둘 것인가와 맞물려 있다.
- 쌍자음을 별도 키로 두면 자음 키가 14개에서 19개로 늘어난다. 또 "ㄱ을 골랐는데 ㄲ 자리는 왜 안 열리지?"라는 혼란이 생긴다. 쪼개 두면 ㄱ 하나로 ㄱ과 ㄲ 자리가 모두 열린다.
- 겹모음은 쪼개면 오히려 어색하다. "ㅘ"를 "ㅗ"와 "ㅏ"로 나누면 "과"라는 글자가 ㄱ, ㅗ, ㅏ 세 칸이 되어 단어 길이가 실제보다 길어 보인다. 모음은 21개를 모두 키보드에 두었다.
const KOREAN_LAYOUT = [
  ["ㄱ","ㄴ","ㄷ","ㄹ","ㅁ","ㅂ","ㅅ","ㅇ","ㅈ","ㅊ"],
  ["ㅋ","ㅌ","ㅍ","ㅎ","ㅏ","ㅐ","ㅑ","ㅒ","ㅓ","ㅔ"],
  ["ㅕ","ㅖ","ㅗ","ㅘ","ㅙ","ㅚ","ㅛ","ㅜ","ㅝ","ㅞ"],
  ["ㅟ","ㅠ","ㅡ","ㅢ","ㅣ"],
];
화면 키보드에는 기본 자음 14개와 모음 21개, 총 35개 키가 있다. 분해 표의 모든 결과가 이 35개 안에 들어가도록 맞춘 것이 핵심이다. 표와 키보드가 어긋나면 "절대 맞힐 수 없는 칸"이 생긴다.
물리 키보드로 한글을 입력받는 방법
데스크톱에서는 화면 버튼을 누르는 것보다 키보드로 바로 치는 게 편하다. 영어 모드는 간단하다. keydown 이벤트에서 event.key가 알파벳이면 그대로 추측으로 처리한다.
한글은 그렇게 할 수 없다. 한글 입력기는 키를 누를 때마다 바로 글자를 확정하지 않고 조합 중 상태를 거친다. ㅇ을 누르면 "ㅇ", ㅖ를 누르면 "예"로 바뀌는 식이다. 이 동안 keydown의 event.key는 브라우저와 운영체제에 따라 "Process"나 조합 전 영문 키 값이 나오기도 해서 믿을 수 없다.
홀리맨은 화면 밖에 보이지 않는 <input>을 두고 입력기가 만든 결과 문자열을 읽는 방식을 택했다.
<input
  ref={koreanInputRef}
  value={typed}
  onChange={(event) => {
    const value = event.target.value;
    setTyped(value);
    applyKoreanInput(value); // 조합 중인 값도 즉시 분해해서 추측으로 처리
  }}
  onCompositionEnd={(event) => commitKoreanInput(event.currentTarget.value)}
  onKeyDown={(event) => { if (event.key === "Enter" && typed) commitKoreanInput(typed); }}
  onBlur={() => { if (!disabled) setTimeout(() => koreanInputRef.current?.focus(), 0); }}
  aria-label="한글 키보드 입력 캡처"
  className="fixed left-[-9999px] top-0 h-px w-px opacity-0 pointer-events-none"
/>
const applyKoreanInput = (value: string) => {
  for (const char of decomposeHangul(value).replace(/\s/g, "")) onGuess(char);
};
const commitKoreanInput = (value: string) => {
  applyKoreanInput(value);
  setTyped("");                                    // 입력창 비우기
  requestAnimationFrame(() => koreanInputRef.current?.focus());
};
흐름을 정리하면 이렇다.
- 입력창에 값이 바뀔 때마다(조합 중 포함) 문자열 전체를 자모로 분해해서 각 자모를 추측으로 보낸다.
- 이미 고른 자모는 게임 로직에서 무시하므로, "ㅇ" → "예"로 바뀌며 ㅇ이 다시 들어와도 문제없다.
- 조합이 끝나면(
compositionend) 입력창을 비운다. - 포커스를 잃으면 다시 가져와서, 사용자가 화면을 클릭한 뒤에도 계속 타이핑할 수 있게 한다.
조합이 끝날 때까지 기다리지 않고 바로 반영하기 때문에, ㅇ을 누르는 순간 단어의 ㅇ 자리가 열린다. 반응이 빠르다는 느낌이 게임에서는 중요했다.
즉시 반영의 부작용: 겹모음
다시 보니 이 방식에는 함정이 하나 있다. 두벌식 자판에는 ㅘ 키가 따로 없다. ㅗ를 누른 뒤 ㅏ를 누르면 입력기가 둘을 합쳐 ㅘ를 만든다. 그런데 홀리맨은 조합 중인 값을 즉시 추측으로 보내기 때문에, ㅘ를 입력하려는 과정에서 ㅗ가 먼저 추측으로 들어간다. 정답 단어에 ㅗ가 없다면 사용자는 ㅘ를 쳤을 뿐인데 오답 한 번이 기록된다. ㅝ(ㅜ+ㅓ), ㅢ(ㅡ+ㅣ), ㅚ(ㅗ+ㅣ) 등도 마찬가지다.
쌍자음에도 비슷한 문제가 있다. Shift를 눌러 ㄲ을 치면 입력창에는 음절이 아닌 낱자 "ㄲ"(호환용 자모 U+3132)이 먼저 들어온다. decomposeHangul은 한글 음절 영역(U+AC00~U+D7A3)만 분해하고 나머지는 그대로 두기 때문에, "ㄲ"은 쪼개지지 않은 채 추측으로 들어간다. 정답 칸은 "ㄱㄱ"으로 저장되어 있으니 "ㄲ"은 어디에도 맞지 않는 오답이 된다. 낱자 쌍자음과 겹받침도 분해 표에 추가해 두면 해결된다.
const COMPAT_JAMO: Record<string, string> = { "ㄲ": "ㄱㄱ", "ㄸ": "ㄷㄷ", "ㅃ": "ㅂㅂ", "ㅆ": "ㅅㅅ", "ㅉ": "ㅈㅈ", "ㄳ": "ㄱㅅ", "ㄵ": "ㄴㅈ", "ㄶ": "ㄴㅎ", "ㄺ": "ㄹㄱ", "ㄻ": "ㄹㅁ", "ㄼ": "ㄹㅂ", "ㄽ": "ㄹㅅ", "ㄾ": "ㄹㅌ", "ㄿ": "ㄹㅍ", "ㅀ": "ㄹㅎ", "ㅄ": "ㅂㅅ" };
// decomposeHangul 안에서 음절이 아니면: return COMPAT_JAMO[char] ?? char.toUpperCase();
겹모음 문제의 해결 방법은 몇 가지가 있다.
// 방법 1: 조합 중에는 "확정된 앞부분"만 반영하고 마지막 글자는 기다린다
onChange={(event) => {
  const value = event.target.value;
  setTyped(value);
  const native = event.nativeEvent as InputEvent;
  const settled = native.isComposing ? value.slice(0, -1) : value;
  applyKoreanInput(settled);
}}
// 방법 2: 마지막 글자가 겹모음의 "앞부분"이 될 수 있는 모음이면 잠시 보류한다
const VOWEL_PREFIX = new Set(["ㅗ", "ㅜ", "ㅡ"]); // ㅘㅙㅚ, ㅝㅞㅟ, ㅢ의 앞부분
방법 1은 단순하지만 반응이 한 글자씩 늦어진다. 방법 2는 즉시성을 유지하지만 규칙이 늘어난다. 사용자가 화면 버튼으로 ㅘ를 직접 누르면 이 문제가 없으니, 물리 키보드 경로에서만 다르게 처리하면 된다.
홀리맨에는 두 가지를 섞어 적용했다. 낱자 쌍자음과 겹받침은 분해 표에 추가해 바로 반영하고, 조합 중인 값의 맨 끝 자모가 ㅗ·ㅜ·ㅡ일 때만 그 모음을 450ms 기다렸다가 반영한다. 그 사이에 ㅏ가 들어와 ㅘ가 되면 ㅗ는 버려지고, 아무 입력이 없으면 ㅗ로 처리된다. 나머지 자모는 지금처럼 누르는 즉시 반영되고, 조합이 끝나면(compositionend) 기다리던 것까지 바로 확정한다. 다음 문제로 넘어가면 대기 중인 모음은 버린다.
const applyComposingInput = (value: string) => {
  clearPendingVowel();
  const jamo = decomposeHangul(value).replace(/\s/g, "");
  const last = jamo.at(-1);
  if (!last || !COMPOUND_VOWEL_PREFIXES.has(last)) { applyKoreanInput(value); return; }
  for (const char of jamo.slice(0, -1)) onGuess(char);
  pendingVowelRef.current = setTimeout(() => { pendingVowelRef.current = null; onGuess(last); }, 450);
};
위 동작은 코드가 의도한 흐름을 설명한 것이다. macOS·Windows의 한글 입력기나 모바일 키보드에서 ㅘ·ㄲ 입력이 오답 없이 반영되는지는 아직 실기기에서 확인하지 못했다.
두 문제 모두 "입력 지연을 없앤다"는 목표와 맞바꾼 부작용이었다. 한글 입력은 "키 하나 = 글자 하나"가 아니라는 사실을 자모 단위 게임에서 다시 확인했다.
다음 문제로 넘어갈 때 상태가 섞이지 않게
마지막으로, 문제를 맞히고 다음 문제로 넘어갈 때 이전 문제의 오답 수가 한 번 깜빡 보이는 버그가 있었다. 다음 문제의 상태를 이펙트에서 새로 만드는 동안, 첫 렌더링에서는 이전 상태가 그대로 쓰였기 때문이다. 홀리맨은 상태에 "어떤 문제의 상태인지"를 나타내는 키를 함께 저장하고, 렌더링 중에 키가 다르면 이전 상태를 쓰지 않도록 고쳤다.
// 영어와 한국어 문제가 같은 ID를 공유하므로 단어까지 키에 넣는다
const stageKey = stage ? `${stage.id}:${stage.word.word}` : null;
const gameState = session?.key === stageKey
  ? session.state
  : stage ? createGameState(stage) : null; // 키가 다르면 즉시 새 상태로 그린다
이펙트를 기다리지 않고 렌더링 단계에서 바로 판단하기 때문에, 느린 모바일 기기에서도 다음 문제의 첫 화면이 깨끗한 상태로 나온다.
정리
- 한글 음절은 유니코드 공식(588, 28로 나누기)으로 초성·중성·종성을 계산할 수 있다.
- 자모를 어디까지 쪼갤지는 화면 키보드의 키 구성을 기준으로 정하고, 분해 결과가 항상 키보드 안에 들어가게 맞춘다.
- 한글 키보드 입력은
keydown이 아니라 입력창의 결과 문자열과composition이벤트로 받는다. - 조합 중인 값을 즉시 반영하면 빠르지만, 겹모음의 앞 글자나 낱자 쌍자음처럼 "조합 과정의 중간 글자"가 추측으로 새어 나갈 수 있다.